分类归档: Arch

Flickr Stats 功能的设计经验

继续我的学习笔记之旅。Flickr 的 DBA Dathan Pattishall 在前几天的 MySQL 大会上分享了 Scaling Heavy Concurrent Writes In Real Time (Record every Referral for Flickr Realtime) ,其中介绍了 Flickr Stats 的设计经验。国内好多 Web 站点其实也在设计类似的功能,只是不知道细节罢了。

数据结构原型

字段               数据类型         
Path_query Varchar(255) PK
Domain Varchar(50)
Owner Bigint
When Date
Object-ID Bigint
Object-Type Tinyint
Counts and stuff Various ints May be some keys

主键是字符串,开销太大。其他的索引如果做主键,也比较大。当表大小超过内存的时候,插入速度很慢,I/O 能力也上不来。

优化数据结构

数据预处理,通过 CONV(SUBSTR(MD5(Url),0,16),16,10) 把 Path_query 修改为 64 位的 ID (8字节), 主键为 ID+Owner+object+object-type,这个统计信息很容易抽象到一个数据对象,这个索引的设计也在于此。

另外补充一点,利用 PHP 的 ip2long() 和 long2ip() 函数对 IP 地址作预处理,耗费的存储空间只为原来地 25%,这是个很有趣的技巧。

数据 Sharding

对于海量的数据,以一个礼拜为间隔,水平分割。按照不同的数据力度每周一个表,每年一个全局表,再加上一个汇总表。数据量越大,InnoDB 存储引擎针对字符串的索引浪费的空间就越大。单个查询的 I/O 也自然大了起来。

所有应用对 DB 的响应要求 是 300 毫秒。但高并发写入的时候响应时间就糟糕起来。Flickr 的 Java 牛人实现了 Referral 队列,每 4000 条做批量处理。这样 IO 拥塞的就解决掉了。

总体的服务器规模过去 介绍过,对专业版用户的数据是永久保留的,而普通用户则只保留几周,为节省空间,采用 MyISAM 引擎,当用户转为专业版时,迁移数据。

补充一下,抓取 URL 是用的 curl 。最后,这篇 PPT 在线观看。

–EOF–

补充一张图:
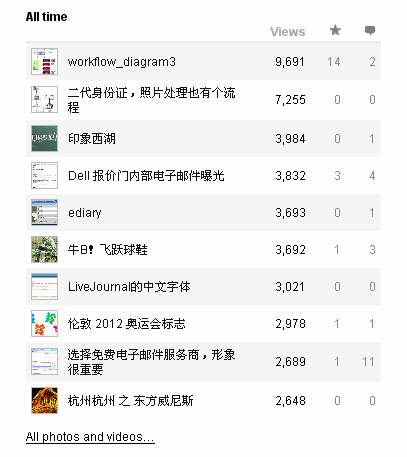
Flickr Stats.png

这是该功能的 UI 设计。

  • 1) 请求触发统计。默认不激活统计。从而节省大量不必要的开销;
  • 2) 统计,没必要过度设计;
  • 3) 元素可点击
  • 4) 设计洁癖

Facebook 的 PHP 性能与扩展性

炙手可热的 Facebook 是用 PHP 开发的。随着一些技术交流,逐渐能看到 Facebook 技术人员分享的经验。近期这个 geekSessions 站点上看到 Facebook 的 Lucas Nealan 分享的文档比较有参考价值。

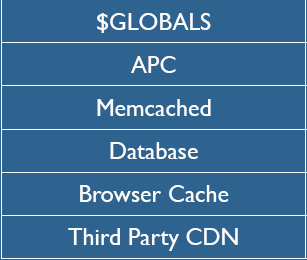
Cache 为 王

任何一个成功的站点都有一套最合适自己的 Cache 策略。

Facebook_Cache_Level.png

Note:这个层次图画的稍微有点问题,不是严格从上到下的。

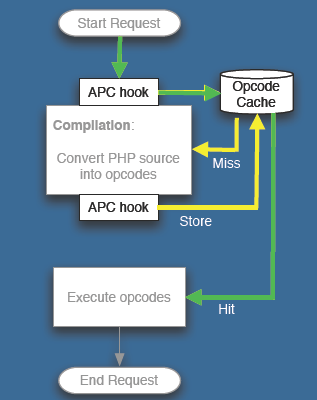
The Alternative PHP Cache , APC

Facebook 平均每个用户每天要访问超过 50 个页面,PHP的页面载入时间的优化就比较重要了。在 PHP Cache 层,Facebook 采用了 APC。

Lucas Nealan 的 PPT 举了一个例子,一个页面显示的时间从 4000 多毫秒降到了 100 多 毫秒。在 apc.stat 关闭的模式下,性能还要更好一些。不过需要重启动或用apc_cache_clear() 来通知更新。

PHP_APC.png

Memcached 层

APC Cache 的是非用户相关的信息,而用户相关的数据 Cache 当然是在 Memcached 中。

Facebook 部署了超过 400 台 Memcached 服务器,超过 5TB 的数据在 Memcached 中。这是当前世界上最大的 Memcached 集群了。也给 Memcached 贡献了不少代码,包括 UDP 的支持和性能上的提升(性能提升超过 20%)。

程序 Profiling

Facebook 开发人员大量采用 Callgrind 、APD、 xdebug 、KCachegrind 等工具进行基准性能测试。任何一个 Web 项目,这也是不可或缺,也是比较容易忽略的一环。所有开发人员都应该具备熟练使用这些工具的能力才好。

补充一下:语言的选择

为什么 Facebook 选择 PHP 而不是其他语言? 用Flickr 的 Cal Henderson 这句话就能说明了: “Languages’s don’t Scale, Architecture Scale”。

从 80-20 的原则看,APC 和 Memcached 是最主要的。在这两个环节上下功夫,受益/开销比要大于另外几个环节。

(上面的图是从 Lucas Nealan 的文档截的,版权所有是他的)
–EOF–

Skype 用 PostgreSQL 支撑海量用户

自从 MySQL 被 Sun 收购后,相信很多对该收购不放心的朋友会转而看好 PostgreSQL 的前途。虽然比较大的 Web 2.0 站点数据库方案基本都采用 MySQL ,不过也有用 PostgreSQL 并且跑的不错的。今天看到 Skype Plans for PostgreSQL to Scale to 1 Billion Users 这个帖子,对 PostgreSQL 在大型网站应用上的部署算是有了一点了解。

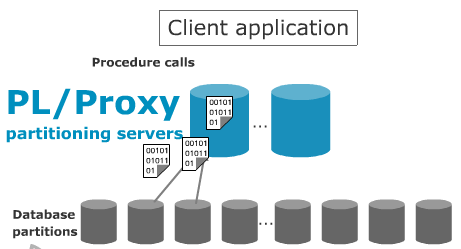
Skype 在数据库上的横向扩展能力以 PL/Proxy 为基础的。其实几乎所有部署 MySQL 的站点也都在考虑 Scale Out (相比 Scale Up) 的扩展方案,也有 MySQL Proxy 这样的产品推出来,只是看起来还不够成熟。PL/Proxy 的设计思想类似 Teradata 的 Hash 机制,数据存储对客户端是透明的,客户请求发送到 PL/Proxy 后,由这里分布式存储过程调用,统一分发,示意图如下:

PL_Proxy.png

PL/Proxy 的设计初衷就是在这一层充当「数据总线」的职责,所以,当数据吞吐量支撑不住的时候,只需要增加更多的 PL/Proxy 服务器即可。(虽然随着服务器越多,通信的开销越大,但只要不大于某个规模,似乎还不足以成为比较大的问题)

随着数据总线层的水平扩展,连接池的问题就凸显出来。Skype 在连接池上的解决方案是采用 PgBouncer,PgBouncer 极大地增强了 PostgreSQL 的连接数扩展能力。顺便说一下,「池」有三种级别:Session 池、事务池、语句池。

Skype 另外开发了一套工具包: SkyTools 来进行数据库的维护,主要是解决数据的复制与队列以及失败接管问题。

整体看下来,围绕着 PostgreSQL 的解决方案其实蛮成熟的。BTW,看起来挺适合阿里旺旺的 :)

–EOF–

有关 Alexa 与 AOL 部署集群文件系统

这两天关注了一下基于 SAN/NAS 的集群文件系统的产品。找到了关于 Alexa 的一则旧闻,之后又发现了一篇关于 AOL 部署 SAN 文件系统的文章。

Alexa 的相关数据

Alexa 超过 1000 台 Linux 服务器 Farm,每半年增长 300T 新数据。经过了同类产品的选型后,最后选择了 Ibrix 融合文件系统。

SAN 使用的是 HP Modular Smart Array (MSA1000) ,最大支持 12T ,Cache I/O 最大 3 万个,算是个中低端的阵列。Amazon 没有透漏这套系统的吞吐能力,只是说 Ibrix 这套系统能达到 1T 的 I/O 聚合能力,单个 NameSpace 可达 16PB 容量。

不过从现在的一些迹象上来看,Amazon 对存储层重新做了改造。这套解决方案被替换掉了也说不定.

AOL 的相关数据

原有状况:3000 台主机通过 10000 多个光纤通道端口连接到传统的 SAN 上。其中有 8PB 的非结构化数据,分布在大约 1000 台 文件服务器上。管理维护的复杂度可想而知。

解决方案:文件服务器采用直连的磁盘,每个 12 块 700GB 的 ATA 磁盘,然后通过 Ibrix 融合文件系统进行集群化。

看起来,Ibrix 提供的解决方案很有竞争力。现在一些比较大的用户对于存储层的集群的需求越来越多,快成为趋势,一揽子解决方案还是有必要的,毕竟不是每家技术能力都强如 Amazon、Google ,有的时候用第三方的成本是能小于自己动手 DIY 的。

–EOF–